Abierto el plazo de las nuevas convocatorias

Elegir un modelo de IA ya no es suficiente: cómo saber cuál funciona mejor para cada tarea

Cada vez que aparece un nuevo modelo de inteligencia artificial, las comparativas se llenan de puntuaciones, tablas y pruebas de rendimiento. Son útiles para conocer avances, pero pueden llevar a una conclusión equivocada: que existe un modelo claramente superior para cualquier situación.

El mejor modelo depende del problema

Un modelo puede destacar en razonamiento matemático y otro ofrecer mejores resultados al resumir documentos extensos. Algunos responden con rapidez y bajo coste; otros necesitan más recursos, pero resuelven tareas complejas con mayor precisión. También importan el idioma, el formato de los datos, la longitud del contexto y las condiciones de seguridad.

Por eso, elegir un modelo empieza por definir qué se espera de él. No es lo mismo clasificar cientos de solicitudes, extraer información de contratos, asistir a un equipo de desarrollo o generar respuestas para clientes. Cada caso requiere criterios distintos y un umbral de calidad propio.

5 criterios para comparar modelos

El primero es la calidad de la respuesta. Hay que comprobar si el modelo resuelve correctamente la tarea y si mantiene ese nivel cuando cambian los datos o la formulación de la petición.

El segundo es la fiabilidad: una respuesta convincente puede contener errores, omisiones o referencias inventadas.

El tercer criterio es la latencia. En una herramienta de uso interno puede ser aceptable esperar unos segundos; en una aplicación interactiva, ese retraso puede perjudicar la experiencia.

El cuarto es el coste total, que incluye tokens, llamadas adicionales, infraestructura y revisión humana.

El quinto es la adecuación al entorno: privacidad, residencia de datos, permisos, integración y disponibilidad.

Diseñar una evaluación propia

La comparación debería partir de un conjunto de ejemplos representativos del trabajo real. Ese conjunto, conocido como dataset de evaluación, debe incluir casos habituales, situaciones límite y ejemplos en los que una respuesta incorrecta pueda generar un perjuicio. Conviene definir de antemano qué se considera una respuesta válida y quién la revisará.

Después se ejecutan las mismas pruebas con los modelos candidatos y se registran resultados. Además de medir exactitud, interesa observar errores recurrentes, consistencia, tiempo de respuesta y coste por tarea completada. En sistemas que utilizan recuperación de información o herramientas externas, la evaluación debe cubrir el flujo completo, no únicamente la respuesta del modelo.

Los benchmarks son un punto de partida no una decisión

Los benchmarks públicos permiten seguir la evolución de los modelos y comparar capacidades bajo condiciones comunes. El AI Index 2026 de Stanford recoge avances rápidos en rendimiento y adopción, pero una puntuación agregada no permite anticipar cómo responderá un modelo ante los datos, restricciones y usuarios de una organización concreta.

También conviene repetir las pruebas cuando cambia el modelo, el prompt, la base documental o la configuración. Una actualización puede mejorar una capacidad y empeorar otra. La evaluación continua permite detectar ese cambio antes de que afecte a los usuarios.

La decisión es técnica y de negocio

La selección de modelos no debería recaer únicamente en quien desarrolla la solución. Producto, seguridad, operaciones y negocio deben acordar qué nivel de calidad se necesita, qué riesgos son aceptables y cuánto cuesta mantener el sistema. En algunos casos, la mejor opción será combinar modelos: uno más ligero para tareas sencillas y otro más capaz cuando la complejidad lo justifique.

El trabajo con modelos generativos exige criterio para diseñar pruebas, interpretar resultados y mantener soluciones en funcionamiento. Esa capacidad es cada vez más importante para los perfiles que construyen productos y sistemas basados en IA.

El Máster de IA Generativa Avanzada de The Bridge aborda el diseño, la evaluación y la operación de sistemas de IA en entornos reales. Está dirigido a profesionales con base técnica que quieren profundizar en arquitecturas, calidad, costes y despliegue.

Consultar el programa de The Bridge


Imagen del autor

The Bridge

The Bridge es una aceleradora digital que potencia el talento de las personas y el empleo de calidad a la vez que mejora la productividad de las empresas favoreciendo así al crecimiento económico.

Sigue leyendo. Más post para ti.

¡Suscríbete a la newsletter!

Cada vez que aparece un nuevo modelo de inteligencia artificial, las comparativas se llenan de puntuaciones, tablas y pruebas de rendimiento. Son útiles para conocer avances, pero pueden llevar a una conclusión equivocada: que existe un modelo claramente superior para cualquier situación.

El mejor modelo depende del problema

Un modelo puede destacar en razonamiento matemático y otro ofrecer mejores resultados al resumir documentos extensos. Algunos responden con rapidez y bajo coste; otros necesitan más recursos, pero resuelven tareas complejas con mayor precisión. También importan el idioma, el formato de los datos, la longitud del contexto y las condiciones de seguridad.

Por eso, elegir un modelo empieza por definir qué se espera de él. No es lo mismo clasificar cientos de solicitudes, extraer información de contratos, asistir a un equipo de desarrollo o generar respuestas para clientes. Cada caso requiere criterios distintos y un umbral de calidad propio.

5 criterios para comparar modelos

El primero es la calidad de la respuesta. Hay que comprobar si el modelo resuelve correctamente la tarea y si mantiene ese nivel cuando cambian los datos o la formulación de la petición.

El segundo es la fiabilidad: una respuesta convincente puede contener errores, omisiones o referencias inventadas.

El tercer criterio es la latencia. En una herramienta de uso interno puede ser aceptable esperar unos segundos; en una aplicación interactiva, ese retraso puede perjudicar la experiencia.

El cuarto es el coste total, que incluye tokens, llamadas adicionales, infraestructura y revisión humana.

El quinto es la adecuación al entorno: privacidad, residencia de datos, permisos, integración y disponibilidad.

Diseñar una evaluación propia

La comparación debería partir de un conjunto de ejemplos representativos del trabajo real. Ese conjunto, conocido como dataset de evaluación, debe incluir casos habituales, situaciones límite y ejemplos en los que una respuesta incorrecta pueda generar un perjuicio. Conviene definir de antemano qué se considera una respuesta válida y quién la revisará.

Después se ejecutan las mismas pruebas con los modelos candidatos y se registran resultados. Además de medir exactitud, interesa observar errores recurrentes, consistencia, tiempo de respuesta y coste por tarea completada. En sistemas que utilizan recuperación de información o herramientas externas, la evaluación debe cubrir el flujo completo, no únicamente la respuesta del modelo.

Los benchmarks son un punto de partida no una decisión

Los benchmarks públicos permiten seguir la evolución de los modelos y comparar capacidades bajo condiciones comunes. El AI Index 2026 de Stanford recoge avances rápidos en rendimiento y adopción, pero una puntuación agregada no permite anticipar cómo responderá un modelo ante los datos, restricciones y usuarios de una organización concreta.

También conviene repetir las pruebas cuando cambia el modelo, el prompt, la base documental o la configuración. Una actualización puede mejorar una capacidad y empeorar otra. La evaluación continua permite detectar ese cambio antes de que afecte a los usuarios.

La decisión es técnica y de negocio

La selección de modelos no debería recaer únicamente en quien desarrolla la solución. Producto, seguridad, operaciones y negocio deben acordar qué nivel de calidad se necesita, qué riesgos son aceptables y cuánto cuesta mantener el sistema. En algunos casos, la mejor opción será combinar modelos: uno más ligero para tareas sencillas y otro más capaz cuando la complejidad lo justifique.

El trabajo con modelos generativos exige criterio para diseñar pruebas, interpretar resultados y mantener soluciones en funcionamiento. Esa capacidad es cada vez más importante para los perfiles que construyen productos y sistemas basados en IA.

El Máster de IA Generativa Avanzada de The Bridge aborda el diseño, la evaluación y la operación de sistemas de IA en entornos reales. Está dirigido a profesionales con base técnica que quieren profundizar en arquitecturas, calidad, costes y despliegue.

Consultar el programa de The Bridge


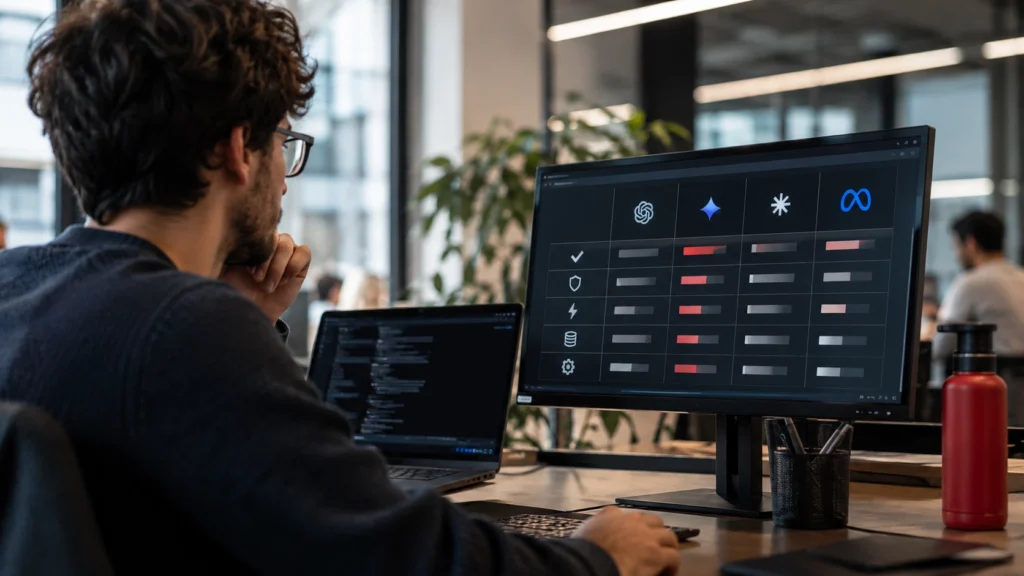
Desarrollador comparando herramientas de IA